
长任务换 Gemini 4 Argon 前,这份灰度清单要先跑
Gemini 4 Argon 已全面开放。它适不适合你的编码智能体,不该先看跑分,而该先用任务、成本和回滚三道门做一次小流量验收。
一段跨几十个文件的重构,最怕的不是模型写错一行代码,而是它在第 47 个工具调用后还在往前冲,预算、上下文和回滚路径却已经没人盯了。
Gemini 4 Argon 在今天全面开放。Google 给它的标签很硬,复杂工程、长链推理、100 万 token 的统一输入输出上限。API 首发价是每百万输入 token 2 美元、输出 token 10 美元,缓存输入有 95% 折扣。很多团队看到这里,大概已经在想,要不要把现有的编码智能体切过去。
我觉得这个问题不该从“它能不能赢过谁”开始。模型刚全量开放,排行榜和演示会很热闹,但你的仓库不会因为一张榜单变得好迁移。真正该问的是,它能不能在你的长任务里把收益留下来,同时不把失败变得更难收拾。
Google 自己给了一个很适合拿来拆的案例。它们让 Argon 处理开源 Agent Development Kit 的性能优化,输入不是一句“帮我提速”,而是一套 .agents/skills 规则和一段明确目标。公开说明里,审查后合入的改动把长会话的内存会话准备时间降低约 40%,冷启动导入加快约 21%。对应的 公开 commit 也能看到。
这件事最有价值的部分,不是 40% 这个数字。是它把模型放进了一个已经有规则、有可测目标、有人工审查的通道里。长任务模型真正值得试的地方,往往也在这里。
图 1 Google 官方发布页主视觉,产品能力与价格需以官方页面为准。
先挑对任务,别先挑最难的活
Argon 的 100 万 token 上限听上去像一张可以塞下整个仓库的桌子。可工程任务不是把文件倒上去就结束了。上下文越长,错误目标、过期约束和无关日志也会一起被带进去。一个能看很多材料的模型,仍然可能在错误的约束下,非常努力地做错事。
适合首轮灰度的,不是“把下个大版本交给它”。更像是这几类已经能量化的工作。
- 一组范围清楚的跨文件重构,能通过已有测试和静态检查判断结果
- 长会话性能排障,输入包含 profile、基准和可复现命令,目标是缩短某个可测路径
- 有完整代码评审和回滚机制的依赖升级,允许模型提出改动,但不允许它自行合并
不适合一上来交出去的,恰好是那些需求还在变、验收标准靠口头感觉、出错后影响很难撤销的事情。模型的上下文再大,也补不上一个没有定义完成的任务。
Google 在发布说明中说,Argon 在 Antigravity 里帮助内部团队提升 agentic 代码提交,并减少代码回滚。这是值得关注的官方信号,不是你团队的结果。把它翻译成工程语言,就是首轮必须同时记录提交成功率、人工打回率和回滚率。只看“完成了多少任务”,很容易把一串需要人收尾的改动算成生产力。
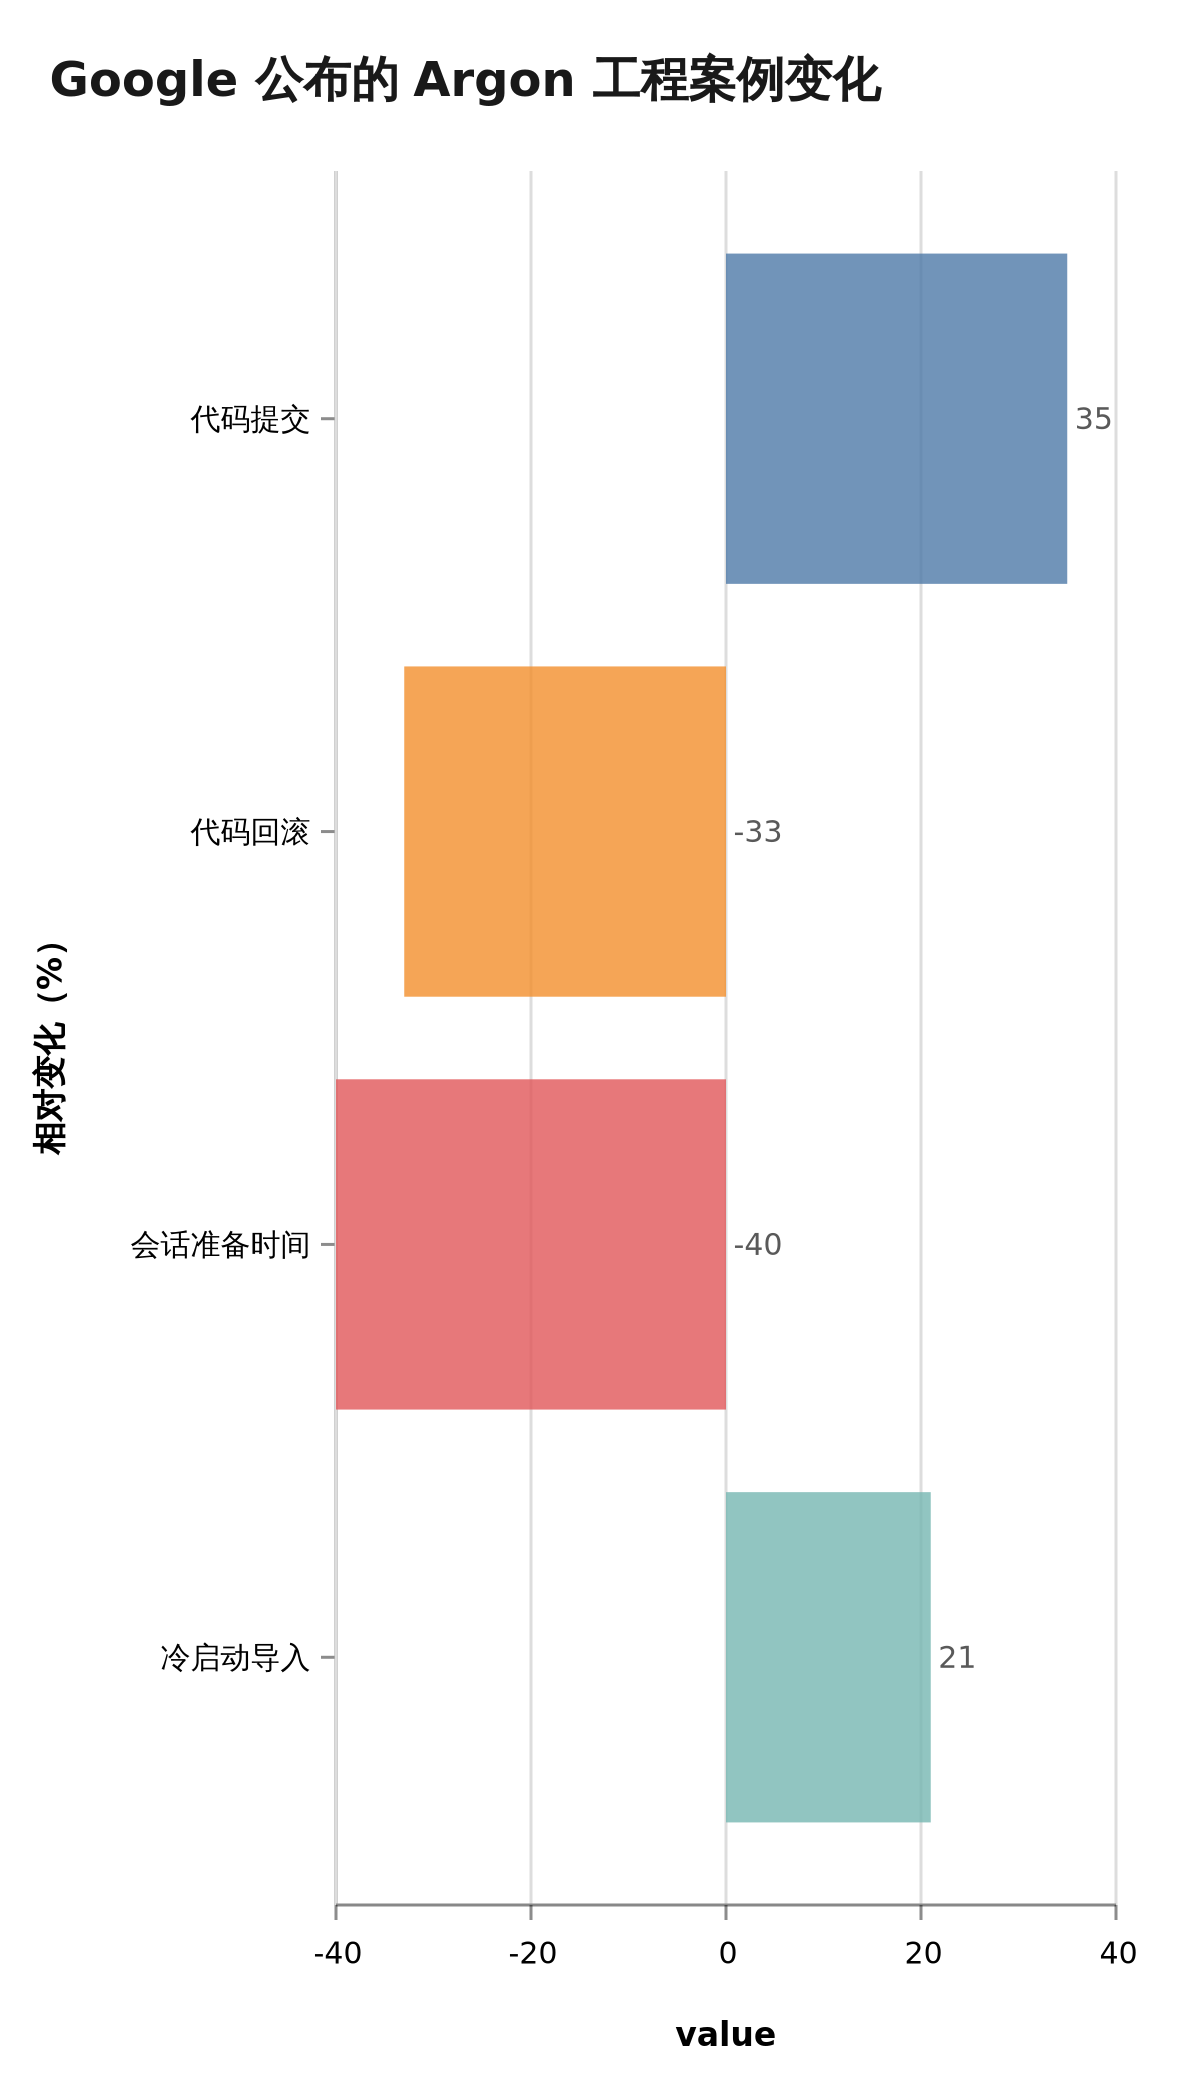
图 2 Google 公布的 Argon 工程案例相对变化。代码提交与冷启动导入是增长,代码回滚与会话准备时间是降低。均为官方口径,未做独立验证。
把 100 万 token 当成成本上限,不是免费容量
Google 给出的首发费率是输入每百万 token 2 美元、输出每百万 token 10 美元,优惠期截至 11 月 30 日。缓存输入的折扣很大,但缓存并不会自动拯救每一种长任务。
如果一次排障把大量历史日志、生成物和重复文档塞进上下文,真正昂贵的可能不是输入,而是模型沿着错误方向产生的长输出、反复工具调用和后续人工检查。100 万 token 更像给了你一辆能跑很远的车,油门也更长,路线错了照样会开得更远。
所以灰度时别只设一个每请求价格。给每个任务补三条账。
- 从接单到得到可合并变更,一共消耗了多少输入、输出和工具调用
- 与当前模型相比,单位通过任务的总成本有没有下降,里面要算上人工审查时间
- 达到预算或调用次数阈值后,智能体是否会停下来交出现场,而不是继续试错
Google 为超长输出提供了 continuation protocol。团队接入前先确认自己的任务编排是否认识“续写”这个状态。能续写不等于应该无限续写,调度器需要知道什么时候保存中间结果、什么时候要求重新规划、什么时候直接把任务退回给人。
规则和回滚,比换模型更早上线
Google 在官方材料里强调,Argon 应在不可逆操作前等待人工确认,并报告负面发现。它还提到对越界捷径的监测与拦截。这些设计方向是对的,不过产品侧的安全能力不能替你接住组织里的权限问题。
如果一个编码智能体可以读取生产配置、修改发布脚本、触发付费资源或写入外部系统,模型换代之前就该先把权限缩小。把读取、生成补丁、运行受限测试、提交 PR 和执行发布拆开。每一段有不同的凭据、不同的允许列表,也有不同的人工确认点。
这不是给模型套一层繁琐的枷锁。反而是让你敢把更长、更有价值的任务交出来。没有回滚的任务只能小心翼翼地试,有明确分支、可复现测试和审批点的任务,才有资格扩大到夜间跑。
Google 的 ADK 案例里,模型拿到的是规则和单段目标,最后合入的也是经过审查的公开改动。这个顺序值得抄。规则先于自治,验收先于扩量。
把一次试用写成可复盘的任务单
模型切换最容易留下一个尴尬的结局,大家都觉得“好像快了一点”,但谁也说不清是哪一步变快、代价又落在了谁身上。给每个灰度任务留一张很短的任务单,反而能把讨论拉回证据。
- 任务边界 允许读取哪些目录,允许改哪些文件,不能碰哪些环境
- 成功标准 要通过哪些测试,性能指标或人工验收的基线是什么
- 预算护栏 最大输入、输出、工具调用次数与总花费阈值
- 人工关口 模型在哪一步必须停下,谁负责看计划、看 diff、点批准
- 失败现场 测试失败、证据不足或权限不够时,要保存哪些日志和中间产物
- 撤销动作 PR、配置和外部副作用分别怎样在可接受时间内恢复
这张单不需要变成一份新流程文档。放进 issue 模板、PR 描述或智能体的任务卡都可以。关键是它必须在模型开始工作前就存在,而不是等出问题后才从聊天记录里找理由。
Google 还提到,Argon 的长输出需要配合 continuation protocol。这里可以做一个很朴素的测试,把同一项任务拆成“一次跑完”和“到阈值后交接”两种执行方式。看后者能不能把计划、已验证结论、未验证假设和待执行命令交代清楚。长任务真正的可靠性,不是模型连续工作了多久,而是它被暂停之后,另一个人或另一个会话能不能接着把事情做对。
一次两周就够的灰度安排
不必为一次模型迁移做一套盛大的评测项目。挑 20 到 30 个已完成过、现在仍可复现的真实任务,保留原来的测试、代码评审与成本记录,用当前模型和 Argon 各跑一遍。目标不是造出一个漂亮榜单,而是找出工作流在哪一段开始有差异。
第一周只开放读取、分析和补丁草案。把模型给出的计划、改动范围、失败报告和测试命令都留下来。重点看它能否在长上下文里持续遵守仓库规则,遇到缺权限、测试不稳定或证据不足时会不会如实停下。
第二周再开放受限测试和创建 PR。每个 PR 都保留人工批准,且预先定义回滚路径。若通过率提高,但审查时间和打回率同步上升,别急着把它算成收益。若成本高一点,但真正减少了夜间排障的来回和无效改动,也值得单独记账。
最终只用四个问题做决定。
- 它在哪一类任务上稳定超过当前基线
- 它多花的钱,是否换回了更少的人工返工
- 失败时会不会留下清晰、可复现的现场
- 团队能否在一小时内撤销它造成的每一类改动
四个问题都答得出来,再扩大流量。答不出来,先别把 100 万 token 当成更大的信任额度。
Gemini 4 Argon 的发布,真正值得开发团队重视的不是又多了一个要比较的模型名,而是长任务开始逼着我们把原来含糊的接入标准写下来。模型会继续变,规则、验收和回滚一旦写进流程,会跟着团队留下来。
如果你正准备换长任务模型,你最想先拿哪一类真实任务做灰度?