
Agent 等结果太久?Mercury 3 的千 token/s 先试这 3 类链路
Mercury 3 把速度推到厂商声称的每秒 1068 token,但真正该先试的是模型等待占主导的低延迟链路;迁生产前,先用一套五项回归把宣传数字拆开。
Agent 的用户等的,从来不是“token 在屏幕上滚得有多快”,而是“这个任务到底什么时候能交回来”。
昨天,Inception 发布了 Mercury 3。它最容易被转发的一行是:NVIDIA GPU 上每秒 1068 个 token,100 万上下文,发布期输入/输出价分别是每百万 token 0.10/0.35 美元。
这几个数确实够亮。但如果你正维护浏览器 Agent、实时检索或客服链路,更该问的一句是:模型这一步真是用户在等的最长一段吗?
Mercury 3 是扩散式大语言模型。它不是严格按下一个 token 一个个往后吐,而是通过多轮迭代并行确定一段文本。Inception 把它定位成速度优先模型,官方称它在自家比较中可比 GPT-6 Luna 和 Claude Haiku 5.5 快 4—8 倍。这里的“官方称”得保留,因为发布页没有给出可供外部复跑的完整硬件、批量和端到端测试设置。
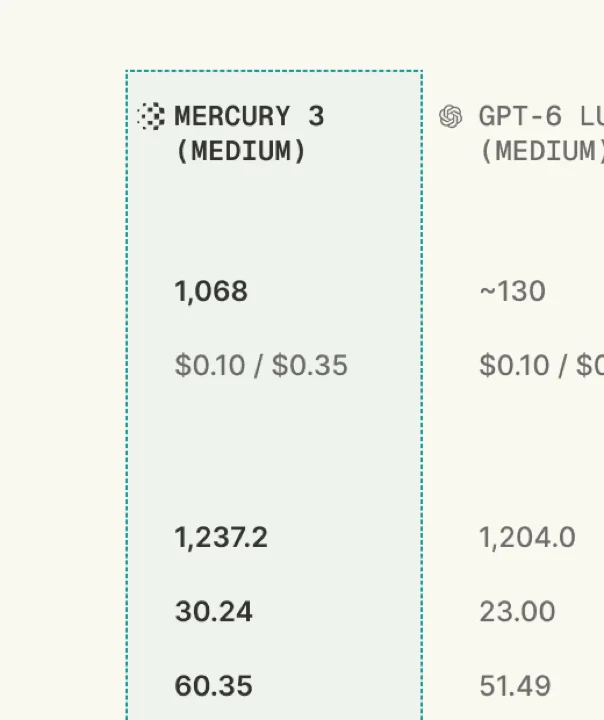
图:Inception 官方基准表的 Mercury 3 速度与价格局部。数字为厂商发布数据,不是本文实测。
先别把吞吐量当成用户少等了几秒
一个 Agent 的等待时间,至少有四段:模型给出第一个字的时间、模型完成回答的时间、工具和网页请求的时间,以及失败后的重试和回退时间。1068 tok/s 只直接回答第二段的一部分。
做过浏览器自动化的人应该很熟这个画面:模型想好了,网页还在转;工具拿到结果了,模型又因为一个格式不对重新来一轮。此时再快的输出速度,也救不了卡在登录、网络、限流和 DOM 变化上的链路。
所以我不会把 Mercury 3 当成“把所有 Agent 换掉”的理由。它更像一张很明确的试验邀请:如果模型生成正好是关键路径上的大头,就拿一小段流量验证;不是,就别让新模型替你背系统设计的锅。
第一类:浏览器 Agent 的短回合循环
Inception 自己把浏览器智能体放在最前面。它称在 50 个真实 Mind2Web 导航任务里,Mercury 3 完成了 50%,与对照模型使用相同 token 量和智能体步骤数。这是厂商在自家框架中的数字,不能直接外推到你的站点,但它提示了一个合适的试验对象:动作短、回合多、每一步都在等模型决定下一步的网页流程。
适合先试的是查询状态、收集公开信息、填写低风险草稿这类任务。把提交、付款、删改数据这类动作留在原来的审批与确认链路里。模型能更快决定“下一步点哪里”,不等于它更应该拥有提交权。
你要看的也不是单个任务的平均耗时,而是同一批回归任务的 P50、P95、工具重试次数和成功率。只盯平均值,最会演戏。
第二类:用户盯着屏幕的即时问答
语音助手、客服对话和教学反馈有一个共同点:用户没有耐心等你在后台做一场思考实验。官方列出的早期合作方里,RevisionDojo 说提示和批改大约一秒返回;Octen 说它的中位生成时间约 0.9 秒、端到端响应约 2.2 秒。两组都是合作方陈述,最适合当成“值得自己量一下”的线索。
这里要把首 token 和完整回答拆开看。一个模型能很快开始说话,却在工具调用或较长推理上拖住;也可能整段输出很快,但第一句来的慢,用户体感照样差。Inception 另设了 Mercury Voice 来压首 token 延迟,本身就说明“输出吞吐”和“开口速度”不是同一回事。
先挑答案短、知识边界清楚、允许回退给人工的会话入口。别拿投诉升级、诊断建议或必须一次答对的关键流程,去赌一条刚发布的速度曲线。
第三类:检索已经很快,生成还在排队的搜索 Agent
Inception 的实时搜索案例给了一个很具体的判断法:如果检索只花几十毫秒,模型生成却占了两秒以上,换模型有机会让用户真切感到不同。反过来,如果你的链路花在向量检索、权限校验、多个 API 和网页抓取上,先换模型大概率只是把不堵的那一段扩宽。
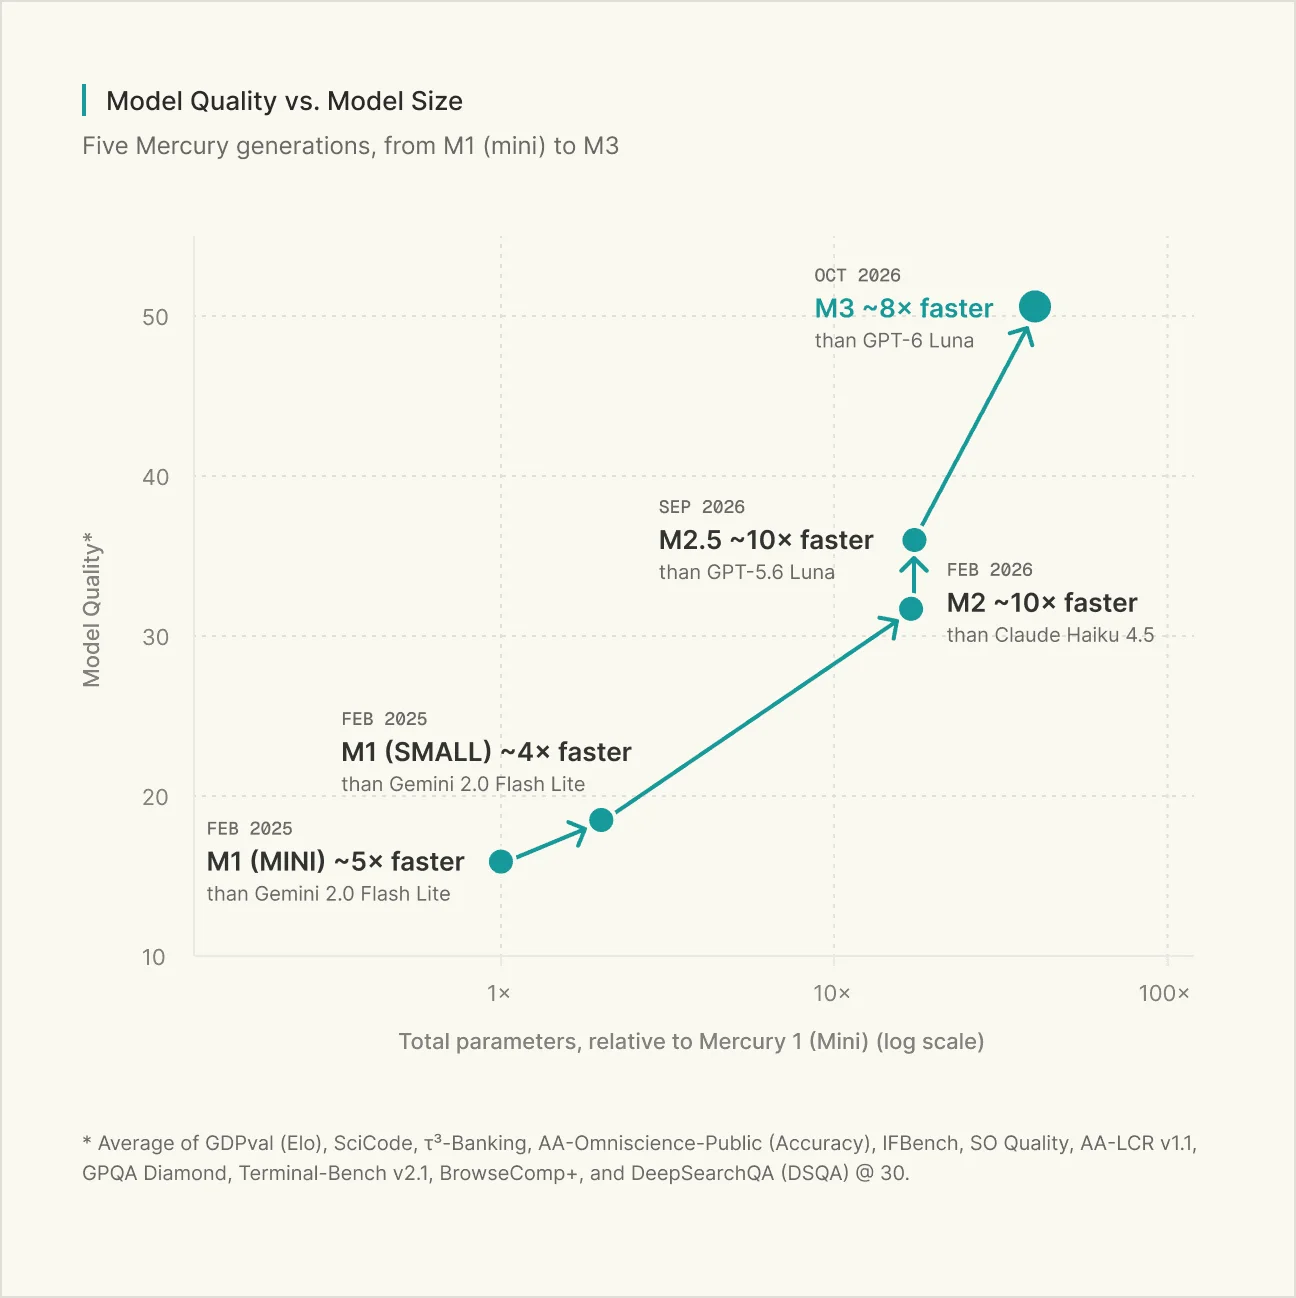
图:Inception 展示的 Mercury 系列规模与质量曲线。图中的质量与速度描述来自厂商材料。
在这类链路里,我会先做一个很朴素的拆账:把过去一周的请求按“检索”“模型首 token”“模型完成”“工具”“重试”分桶。只要模型完成时间没有稳定占到端到端延迟的大头,Mercury 3 的千 token/s 再漂亮,也先留在候选池里。
三类任务,今天先别迁
第一类是长代码改造和复杂推理。发布页的比较对象是速度优先模型,不是用来替代最强推理模型的宣言;长任务里,规划、工具结果和回退往往比连续输出更要命。
第二类是工具时间主导的流程。跑一次数据库、等一次 CI、跨系统拿授权,模型只占几百毫秒时,换模型不会让用户突然准点下班。
第三类是没有独立回归证据的高风险业务。官方材料里有基准、合作方案例和产品承诺,但没有你的输入分布、权限模型和失败成本。这个缺口只能靠自己的回归集补,不能靠更大的吞吐数字补。
一套够用的接入验收:五个数,再加两条刹车线
Mercury 3 兼容 OpenAI API,这让你可以不改业务接口就搭一个旁路实验。最小版本不需要多花活:保留原模型,把同一组请求镜像给新模型;结果先不影响用户,只记日志。
experiment: mercury3-shadow
traffic: 5%
keep_current_model: true
measure:
  - time_to_first_token
  - model_completion_time
  - end_to_end_latency
  - tool_retry_count
  - task_success_rate
五个数里,前三个看速度,后两个防止你把“更快失败”误认成升级。然后给实验加两条刹车线:任务成功率低于现网基线就停止;任何需要人工兜底的高风险动作都不自动扩大流量。
成本也别按发布折扣做全年预算。官方标价是输入 0.20、输出 0.70 美元/百万 token,发布期减半,缓存输入再有折扣;但公告没有把折扣截止日写成你的财务承诺。预算表先用标价,折扣只当试验期的额外余量,比较不容易在上线后变成一场小型事故。
Mercury 3 最值得看的,不是它能不能替你选出“最快模型”。它把一个更细的选择摆在桌上:当模型等待真是瓶颈时,速度可以成为产品能力;当瓶颈在工具、权限和重试时,先把链路理顺,模型再快也只是跑得更快地撞墙。
如果你正在跑 Agent,哪一段现在最拖时间:模型生成、工具调用,还是失败重试?
小岛AI|记录一线实战、踩坑与成长