
Qwen4 开了两周预览:能验 API,但先别迁生产
Qwen4-Max-Preview 兼容两套主流接口,却把推理和答案塞进同一 token 预算。两周窗口适合做影子验证,不适合把生产流量一把切过去。
如果你的服务里已经跑着 OpenAI 或 Anthropic 兼容客户端,Qwen4-Max-Preview 看起来像一件很省心的事:换一个 Base URL、填一个模型名,代码也许就能动。
真正该警惕的,反而是那句容易被略过的兼容性说明。Qwen4 把 max_tokens 和 max_completion_tokens 都当成「思考过程+最终回答」的共同上限。原来只给答案留预算的调用,到了长推理任务里,可能不是模型变笨了,而是答案还没来得及说完,预算已经被内部推理吃掉了。
这不是一篇 Qwen4 的参数复读。11 月 11 日开放的 Qwen4-Max-Preview 官方文档 里,有三个足够让平台工程师动手验证的事实:它兼容 OpenAI Chat Completions、Responses 和 Anthropic Messages;支持图片、视频、工具调用和结构化输出;但只在 Token Plan 中提供预览,11 月 25 日 24:00(北京时间)结束后会下线。
所以问题不是「要不要换掉现在的模型」。更实际的问题是:这两周,值不值得把它拉进你的模型路由和评测台,跑一轮有边界的验证?

预览模型更像一条受控的测试支路:能接入,不等于该接管生产。
协议兼容,和可替换,是两回事
兼容 OpenAI 或 Anthropic 的接口,确实能省掉不少胶水层。已有的消息结构、工具调用封装、JSON Schema 输出约束,大概率不用从零改起。对维护多模型网关的团队来说,这已经很值钱了:先把供应商接入成本压低,再看真实任务是否值得留下。
但「协议能通」只解决了最外层。模型路由真正关心的是语义:默认会不会思考、工具调用的稳定性怎样、结构化输出在边界输入时会不会跑偏、多轮上下文怎么续、超时与重试会怎样放大成本。
Qwen4 的文档明确写了,思考默认开启,reasoning_effort 可选 low、medium 或默认的 xhigh。同一条业务请求若没有显式设定推理力度,延迟、输出长度和费用曲线都可能和旧模型不同。它不是一个可以只靠「SDK 没报错」就判定替换成功的候选后端。
另一个很现实的限制是接入方式。当前预览只支持 Token Plan,不支持按量计费;而且预览结束后模型会下线。做一个短期 benchmark、给内部评测任务开白名单、跑离线回放,都合理。把核心客服、付费生成或自动执行链路直接切过去,就把供应稳定性也一起押进了这两周的窗口。
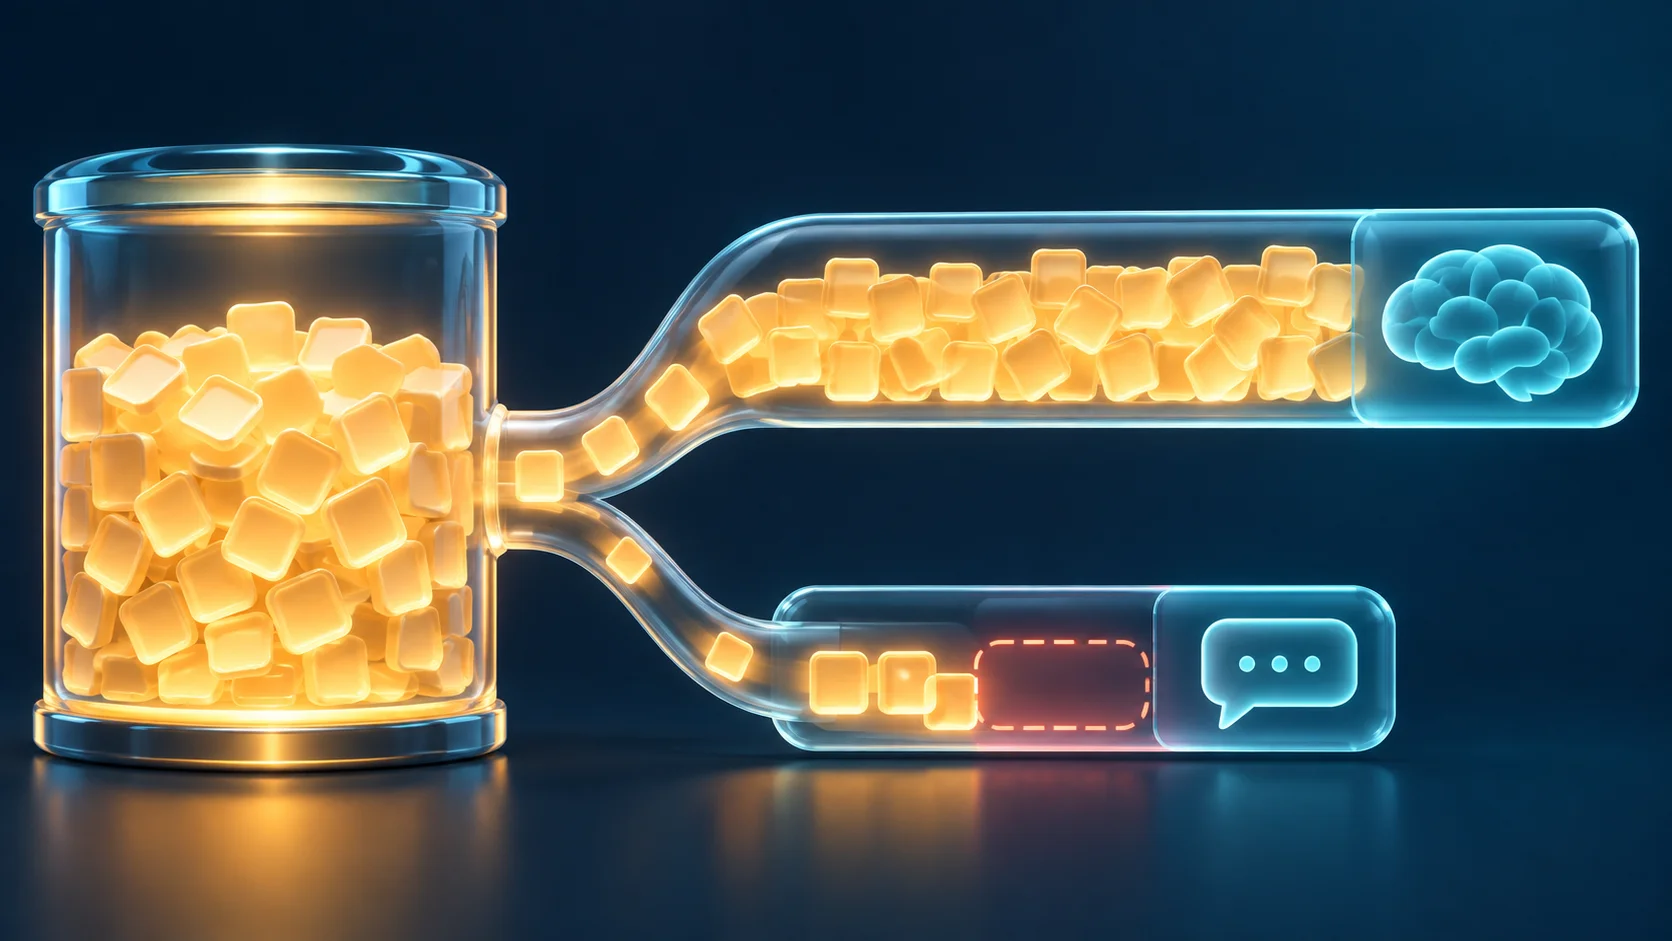
这里的变化不是参数改名:思考和最终回答开始争用同一份输出预算。
真正该先测的,是预算和状态
官方这次对 max_tokens 的说明值得单独拉出来。对于 Qwen4-Max-Preview,max_tokens 等同于 max_completion_tokens,两者都限制思考内容和最终回答的总量。以前把 max_tokens 理解成「最多允许模型答这么多」的服务,可能会在复杂问题上遇到一种很难定位的故障:工具都调用完了,最后给用户的结论却半截没了。
这类问题不该靠调大一个数字赌运气。先把现有线上样本分成三档:短问答、需要工具的任务、长上下文推理。每档挑出不含敏感用户数据的固定样本,记录旧模型的最终输出长度、工具调用轮数、完成率和端到端耗时。然后用同样的系统提示词、同样的工具定义跑 Qwen4。
重点不是比谁写得更漂亮,而是看四个结果:
- 最终回答有没有因预算耗尽而截断;
reasoning_effort从默认值改为medium后,完成率和延迟怎么变;- JSON Schema 输出能否稳定通过你已有的解析器;
- 多轮对话里,历史 assistant 消息的
reasoning_content是否按官方要求保留,而不是被拼进普通content。
最后这一条尤其容易在网关层被「好心处理」坏。官方写得很直白:保留历史思考内容,但不要把它并入普通回答文本。把两者混在一起,短期也许不报错;长对话里却可能污染上下文、拉高输入量,甚至让下一轮模型读到它本不该当作用户可见答案的一段内容。
如果你们有统一的适配层,现在正好可以把这组规则写成 provider contract,而不是散落在某个业务仓库的条件分支里。模型以后换不换,至少这次踩到的坑不用再踩第二遍。
还有一个常被忽略的分界:评测数据和真实用户数据不是同一种东西。预览期的第一轮,不要把带有客户原文、账号权限或可执行凭证的上下文塞进去碰运气。先用脱敏回放集和合成工具结果,把协议、预算和状态机跑顺;确实需要接近真实流量时,再做只记录结果、不产生外部动作的影子调用。模型回答得再像,也不能替你撤回一次已经发出的邮件、一次错误的工单更新,或者一段被写进业务系统的字段。
这一层控制并不复杂。给 Qwen4 单独挂一个 provider 标识,设置请求量上限和总预算上限;工具定义里先移除写操作,只保留查询类工具;日志同时记录模型版本、推理力度、输出是否完整、工具轮数和解析结果。这样一旦发现截断、超时或结构化字段漂移,回看的是一条清楚的实验记录,不是一团混进生产链路的异常。
把这些观察和旧模型的同题结果并排放在一张表里。没有对照,十条「感觉更聪明」的反馈,也很难换来一次值得承担风险的迁移决定。
一份两周窗口内够用的验收单
没有公开跑分、没有正式版承诺时,最稳的做法不是急着给 Qwen4 排名,而是给它设一道能过也能不过的闸门。下面这份清单可以直接贴进评测任务:
- 连通性:分别从 OpenAI Chat Completions、Responses 和 Anthropic Messages 适配路径发一条最小请求,记录请求体、返回结构和错误码。
- 预算:用一条需要完整解释的长推理样本,在默认推理力度和
medium下各跑一次,检查最终回答是否被截断。 - 工具:用一组固定 Function Calling 样本,统计工具参数是否通过既有校验、工具返回后模型能否收束成最终回答。
- 结构化输出:拿线上最常见的一个 JSON Schema 跑正例、缺字段、超长字段三类输入。不是只看「能返回 JSON」,而是看下游解析和重试有没有多出异常。
- 多轮状态:复放一段真实结构、已脱敏的多轮任务,确认
reasoning_content的保存和回传符合文档,同时测输入 token 是否异常上涨。
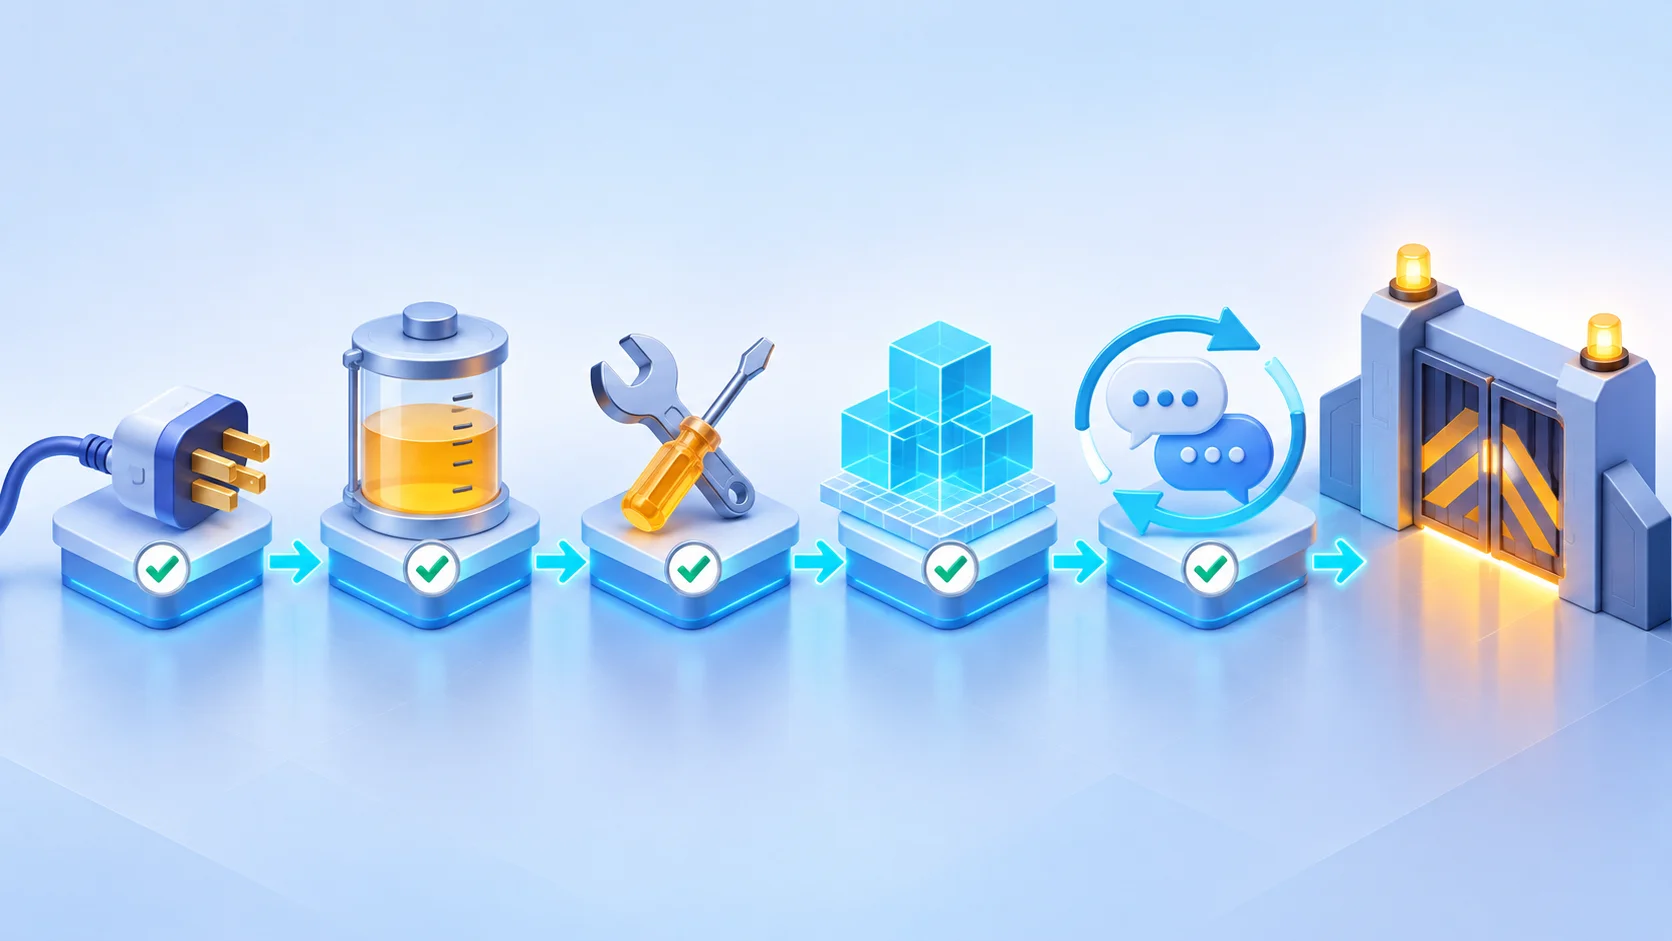
验收不是给新模型打分,是把「能不能安全接进现有系统」拆成可观察的五件事。
这五项都过了,再谈质量比较。若其中任何一项不过,先把它标成「可研究、不可替换」。这不是保守,是把模型能力和系统可靠性分开算账。前者靠一两次好回答很容易显得惊艳,后者要靠边界样本和失败路径慢慢验。
验收结论也别只写「通过」。更有用的写法是把结果分成三层:协议是否兼容、任务是否完成、故障是否可控。第一层回答客户端能不能发出去;第二层回答模型在你的任务上有没有把事办完;第三层才决定它能不能进一条有人负责的业务链路。很多模型接入最后卡住,不是第一层,而是错误重试、限流、超时、工具副作用这些第三层问题。把三层拆开,讨论会少一点「感觉不错」,多一点可以复查的证据。
这次最值得迁走的,其实是评测方法
Qwen4-Max-Preview 给了一个很典型的提示:模型更新越来越像一次接口与运行时共同变更,而不是换个名字、加点上下文长度。
一百万 token、多模态输入、联网搜索、工具调用、结构化输出,这些词都很吸引人。可对已经有产品在跑的团队,先问三件小事就够了:预算语义变了吗?状态怎么续?窗口结束后还在吗?三件事没答清,模型再新,也只适合待在试验台。
这两周更适合做影子流量、离线回放和可复现评测。等正式可用性、计费方式和长期型号稳定下来,再决定是否进入主路由。把一次预览当成一次把评测和迁移闸门补齐的机会,反而不亏。
你们团队给新模型放行时,最先挡在门外的那项验收是什么?
小岛 AI