posts/zcode-long-running-agent-system.md
ZCode 四连更,模型更强反而不是重点
智谱今天给 ZCode 一口气上了四样东西,Goal、Subagents、Remote Control,还有闲时任务。
单看名字,像是 coding agent 产品经理熟练地把热门词抄进版本清单。长任务、多智能体、手机远控、自动调度,同行基本都在往这几个方向卷。谁家再补一个记忆和插件市场,拼图就齐了。
但把 ZCode 3.7.5 的更新日志 和几页官方文档摊开看,四个功能其实在回答同一个问题。
人离开键盘以后,Agent 凭什么还能继续干活,而且不把仓库干烂。
这个问题比模型跑分麻烦多了。
模型会不会写一个函数,已经很少是 coding agent 最难的部分。真正难的是任务跑到第十二轮时,它还记不记得验收条件,失败后能不能停住,子任务有没有越权,手机上追加的一句指令会不会发到错误的环境,凌晨自动跑的活会不会第二天给你留下一地冲突。
好家伙,这已经不是聊天框了。
它更像一套小型任务运行时。
Goal 不是一句更长的 Prompt
Goal 官方文档 给的例子很直白,重构整个模块并保持测试通过,修完所有 TypeScript 编译错误,把 Lighthouse 分数提到 90 以上。
这几句话有一个共同点,目标很短,执行链很长,而且完成与否可以拿证据判断。
输入 /goal 之后,ZCode 会围绕目标反复迭代。每轮结束单独校验,没完成就继续,确认完成才收尾。文档还特意强调,写了计划、列了待办、跑了很久,或者生成一段听起来很像结论的回复,都不算完成。要有文件改动、命令输出、测试结果这类能核对的东西。
这句话有点子牛逼,因为它承认了一个很多 Agent 产品不太愿意说的事实。
模型的自我汇报不可信。
Agent 最常见的翻车不是完全不会,而是做到七成以后语气突然变得很笃定。测试还有三条红的,它已经开始给你写完成总结。代码里留着 TODO,它却说核心链路已经跑通。哦豁,熟悉的汇报型人格。
Goal 的关键不在自动说「继续」,而在把目标、状态、消耗和校验从对话文本里拿出来,交给系统保存。暂停不会丢掉已经跑过的轮次和产物,重新进入会话还能从原位置接着走,跑到用量上限也会停止。
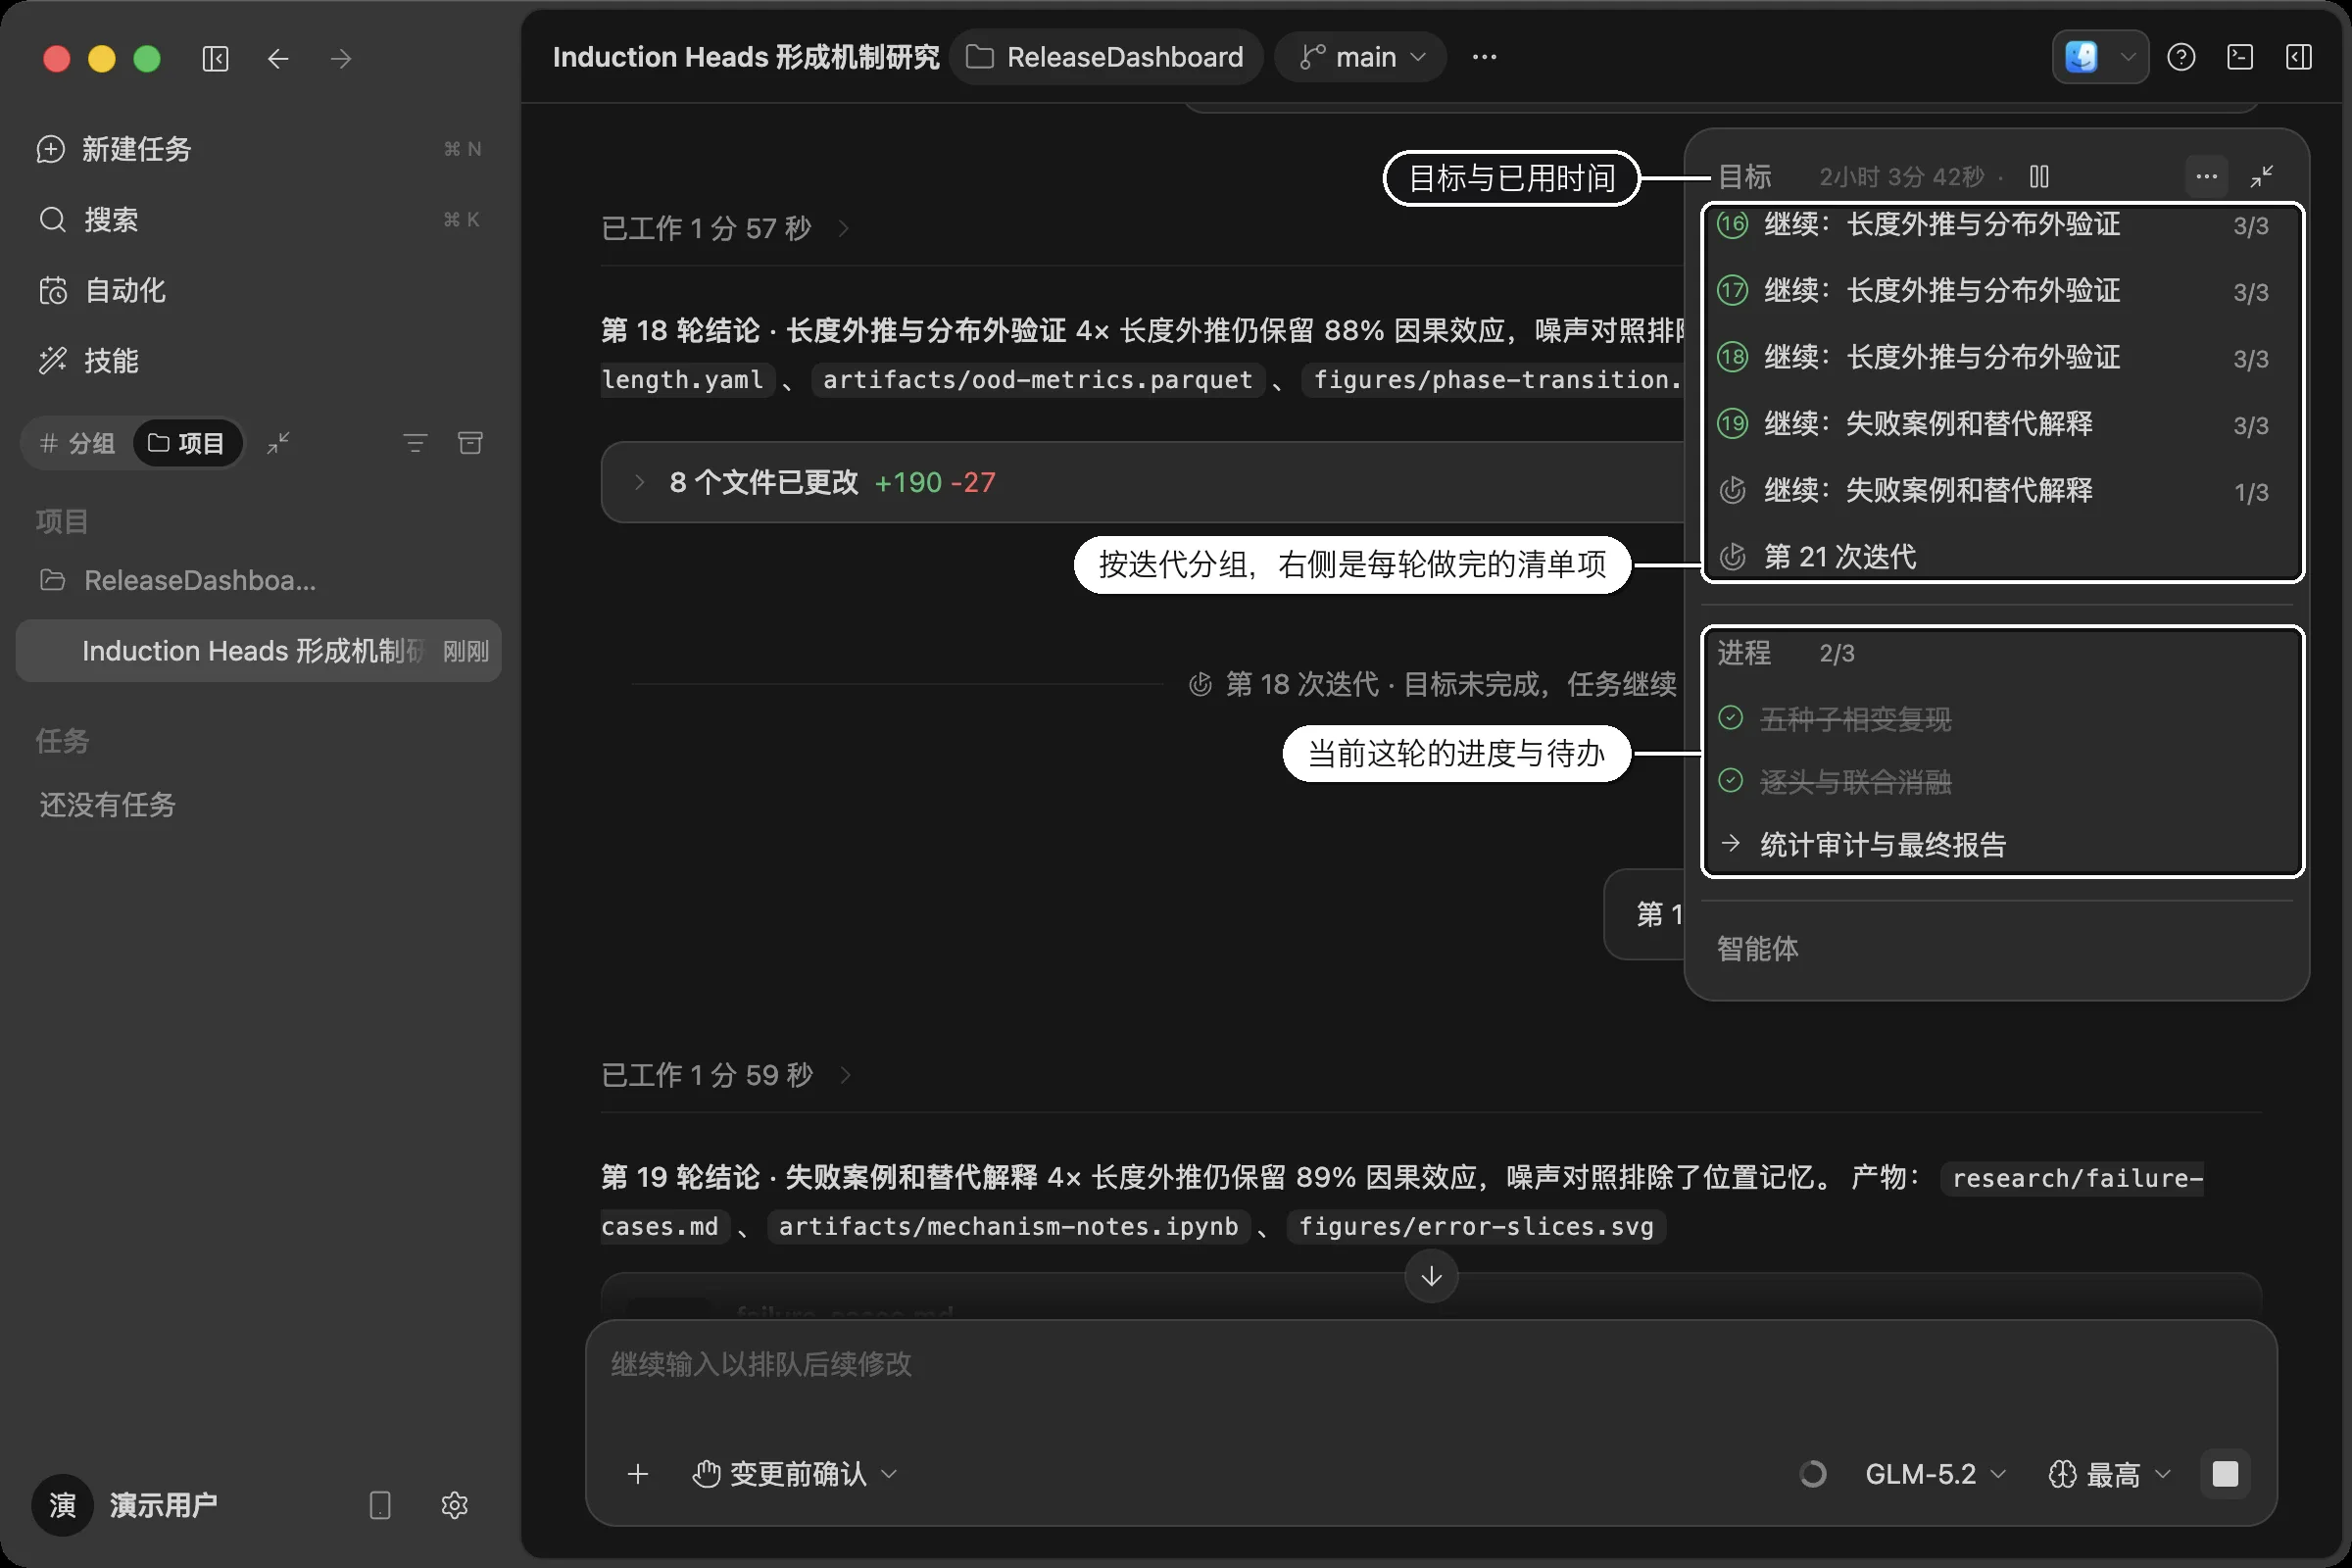
对工程团队来说,这里最值得抄的不是 /goal 这个命令,而是一个很朴素的任务合同。
目标
修复所有 TypeScript 编译错误,不改公开 API

验收
pnpm typecheck 退出码为 0
pnpm test 全部通过
git diff 不包含 packages/public-api

预算
最多 12 轮,最多运行 45 分钟

失败策略
任何迁移脚本失败就暂停,不自动重试写操作
这份东西不漂亮,甚至有点像值班手册。但长期任务能不能放心交出去,靠的就是这些不浪漫的边界。
模型可以换,目标合同不能跟着模型一起漂。
Subagents 真正值钱的是隔离
多智能体最容易被演示视频拍得像《复仇者联盟》,主 Agent 一声令下,几个角色并排开工,最后回来鞠躬汇报。
生产环境没那么热血。多个 Agent 一起改仓库,更像几个人同时在一间很窄的厨房做饭。速度可能快,也可能互相拿错锅,最后还找不到是谁把盐倒了半袋。
ZCode 的 Subagents 文档 里,内置角色分成拥有完整工具权限的 general-purpose 和只读的 Explore。自定义子智能体还能分别设置模型、工具权限、系统指令和思考强度。长任务可以放到后台,主任务不用傻等;只读 Explore 即使在后台运行,也不能修改文件。
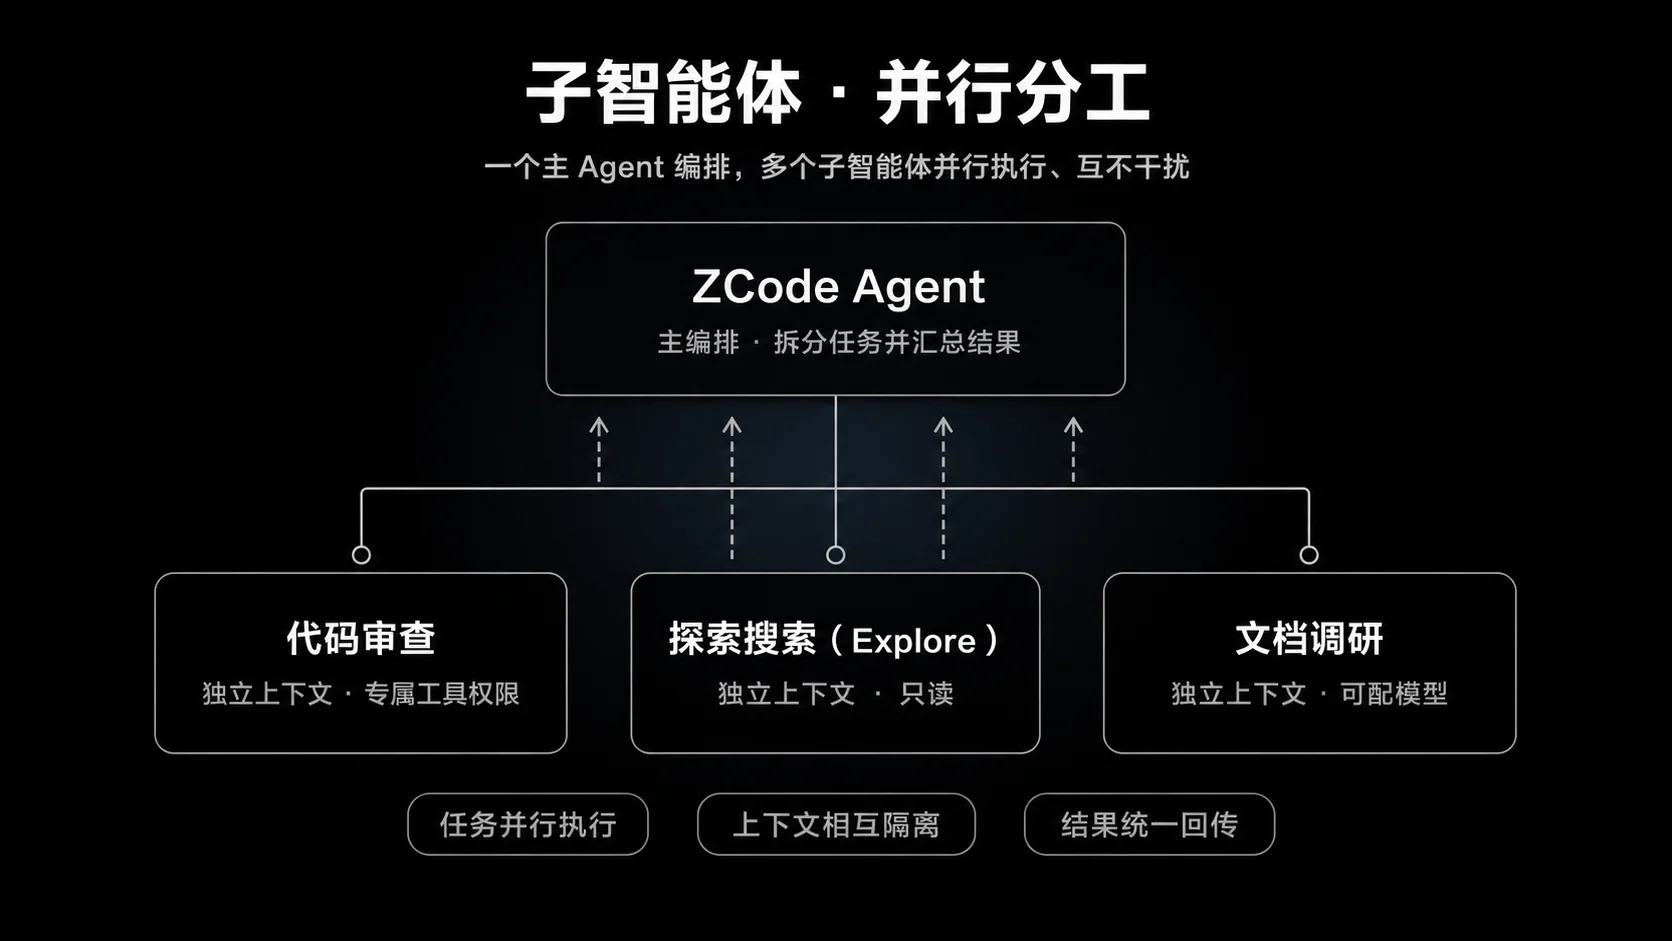
这比「能同时启动几个 Agent」重要得多。
并行只是速度问题,隔离才是可靠性问题。
代码搜索和调用链调研可以交给只读角色,测试生成可以限制在测试目录,发布检查只给日志和构建命令,真正写核心代码的角色再拿编辑权限。每个子任务都带自己的上下文,完成后只把结论和证据汇总回来,主对话就不必吞下几万行搜索噪声。
但文档里也藏着几个现在就该看清的限制。自定义子智能体还是 Beta,目前主要是用户级配置,放在 ~/.zcode/agents/ 下。一个人调顺的 reviewer,不会天然变成仓库里可评审、可共享的团队资产。多个 Agent 操作同一工作区时,磁盘也不会因为上下文隔离就自动变出事务。
所以别急着把六个可写 Agent 一起放出去。先问三个土问题,它们会不会改同一批文件,失败后谁负责回滚,最终由谁跑全量验收。
说真的,多 Agent 最贵的从来不是多花几份 token。
是合并成本。
手机远控不是把代码搬到手机
Remote Control 很容易被理解成「在手机上写代码」。官方说明 反而把边界写得挺清楚,手机只是控制界面,代码、命令和项目环境仍留在桌面端或桌面已经连好的 SSH、WSL、Docker 环境里。
这套设计挺合理。手机适合看状态、补一句要求、暂停任务,不适合复制一份完整开发环境。运行位置不变,依赖和凭据也不用再同步一次。
代价同样明确。
连接地址就是一把临时钥匙,拿到的人可以操作当前窗口。关掉手机页面不会停止远控,得主动点停止;怀疑地址外泄,要刷新二维码让旧地址失效;桌面端一旦离线,手机也干不了活。
厉害了,这几条看着像普通使用提示,实际上已经碰到 Agent 远程运维的核心。
当工具能改文件、跑命令、访问内网服务时,远控链接就不能只按「方便登录」来设计。它需要明确的会话寿命、撤销机制、环境标识和操作审计。屏幕上最好一直告诉你,当前控制的是本地仓库、测试机还是生产跳板机,当前角色能读什么、能写什么。
否则通勤路上随手补的一句「把这个也修了」,可能不是发给你脑子里那台机器。
不是哥们,这种错一次就够写事故复盘了。
闲时任务让所有小问题一起放大
ZCode 3.7.5 让闲时任务可以指定带自定义模型的子智能体,自动化任务还能按分钟设置间隔。此前版本已经加入定时和空闲视图、全局防休眠、后台子任务,并连续修过任务重复安排、计时异常、模型与目标显示错误、排队消息乱序和远程工作区恢复问题。
这些修复记录比功能宣传更有信息量。
只要 Agent 从「你点一下才跑」变成「时间到了自己跑」,所有偶发错误都会乘上执行次数。一次重复写入可能只是多一条记录,每十五分钟重复一次,一夜之后就成了数据清理项目。一次错误重试可能只是浪费两分钟,后台无限重试就会把额度和 API 限流一起吃光。
闲时任务最适合的,不是直接替你改核心业务,而是边界清楚、可重复、失败容易发现的活。更新依赖报告、整理测试失败、扫描文档断链、给积压 issue 做只读分类,都比「自动重构整个仓库」靠谱。
如果真要让它写代码,至少补上幂等键、独立分支、最大运行时间、最大 token、重试上限和人工合并门禁。任务第二次跑时要知道自己已经做过什么,失败时要保留日志和产物,恢复时不能从头再写一遍。
这事儿我也不敢装熟。我还没有把 ZCode 3.7.5 放进真实生产仓库跑一夜,官方也没有公开足够完整的长期稳定性数据。现在能下的判断,只能建立在产品文档、更新日志和公开指标上。
官方公告给了两个挺醒目的数字,GLM-5.2 搭配 ZCode 在 Z.ai Code Bench 的任务整体通过率,比搭配 Claude Code 高 2.39%,缓存命中率超过 98%。
2.39% 能证明 harness,也就是让模型真正干活的那层工程,会影响最终成功率。它不能单独证明 ZCode 已经全面胜过 Claude Code。没有完整任务集、运行配置、失败分类和多轮方差,拿一个百分点直接封王,多少有点发布会气质。
98% 也一样。缓存命中高,通常能降低重复上下文的延迟和成本,但要看缓存覆盖的是哪部分、冷启动占比多少、任务变化后还能不能命中。数字不错,结论先别跑太快。
Coding Agent 的下一仗是能不能收尾
ZCode Agent 文档 把 GLM-5.2 的 1M 上下文、长程编码、弹性推理强度和 Agentic Coding 训练写得很重。这些模型能力当然重要,没有足够强的执行引擎,控制系统再漂亮也只是空转。
可长上下文解决的是「装得下」,不自动解决「做得完」。
Subagents 解决的是分工,不自动解决冲突。Remote Control 解决的是人在外面还能介入,不自动解决权限。闲时任务解决的是按时启动,不自动解决重复执行。Goal 解决的是目标与校验,也仍然需要你写出靠谱的验收条件。
四样东西拼起来,方向才清楚。
未来的 coding agent 不会只比谁第一轮回答更聪明。它们会比谁能在几十轮之后保持目标,谁能把读写权限切干净,谁能算清预算,谁能在失败时停住,谁能拿测试、日志和 diff 证明活真的做完了。
模型负责向前冲,运行时负责别让它冲出护栏。
这次 ZCode 最值得看的,恰好不是又多了四个按钮,而是它开始认真修那条从「会写代码」到「可以交付」的路。
路还没修完。
但总算不只是给聊天框换皮了。